
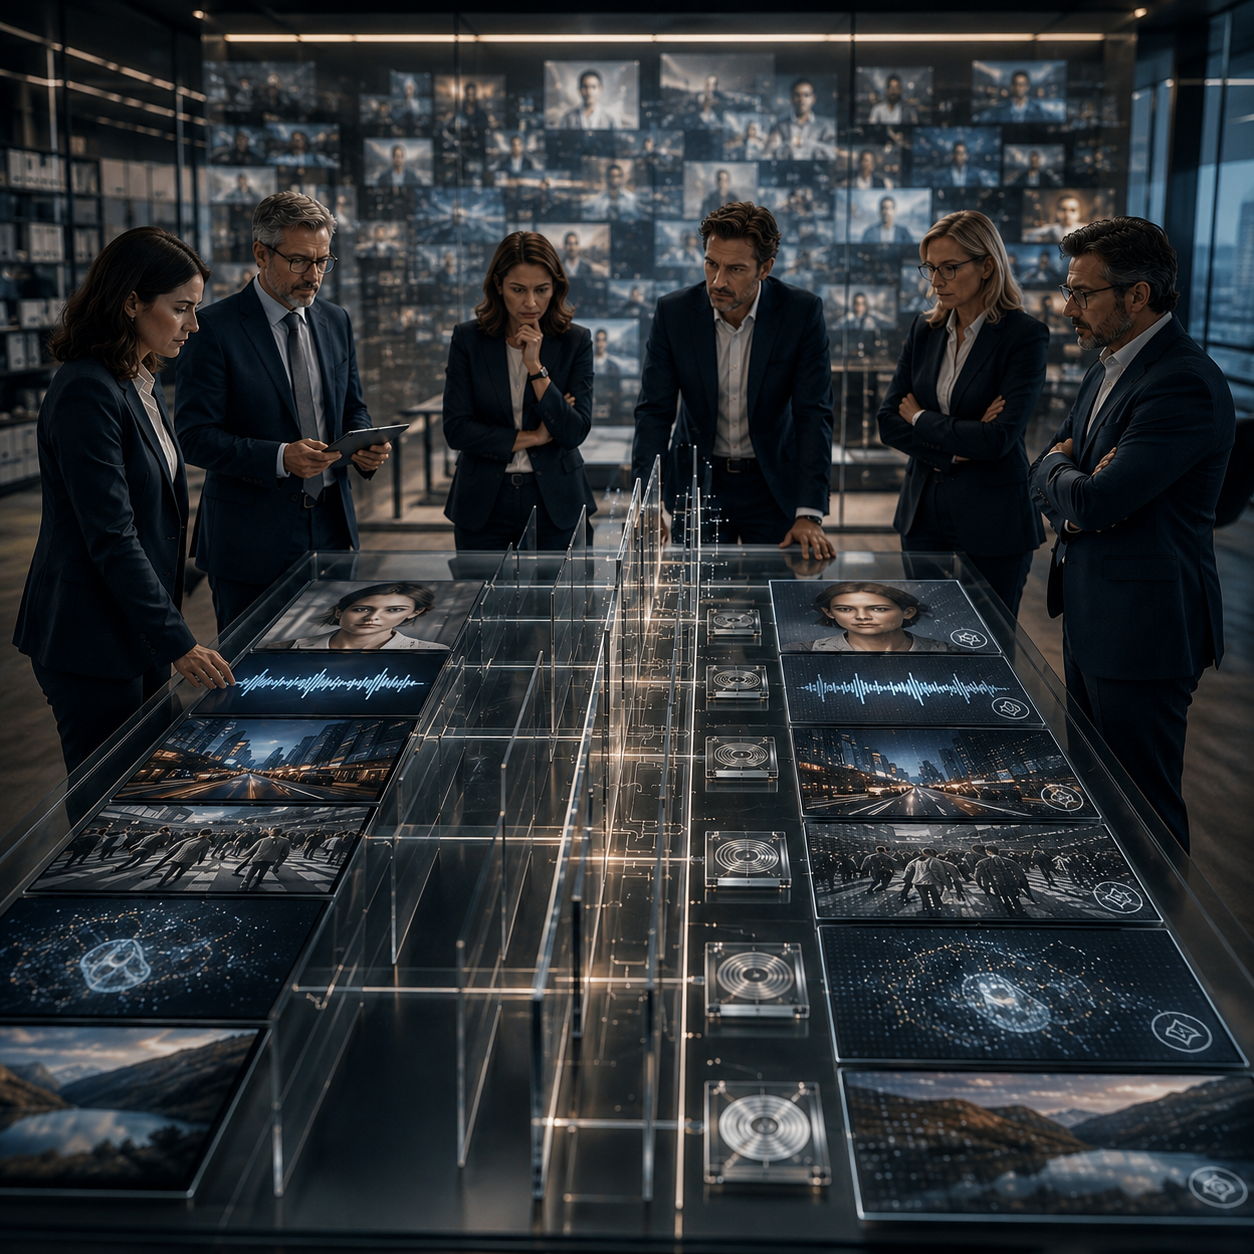
Une image réaliste, une voix clonée, une vidéo modifiée, un texte publié sur un sujet politique, sanitaire ou économique sans que le lecteur sache vraiment s’il a été rédigé par une personne ou généré par une machine.
C’est précisément ce brouillage que l’Europe tente désormais d’encadrer.
Le 10 juin 2026, la Commission européenne a publié un code de bonnes pratiques sur la transparence des contenus générés par intelligence artificielle.
À première vue, le texte pourrait sembler secondaire :
- il s’agit d’un code volontaire
- il propose des standards
- il évoque des marquages techniques, des métadonnées et des systèmes de détection
- il mentionne même des icônes communes pour signaler les contenus générés par IA
La tentation serait donc de le ranger dans la catégorie du droit souple, mais ce serait une erreur, car le code est volontaire tout en s’inscrivant dans un cadre beaucoup plus contraignant :
- l’article 50 de l’AI Act
- des obligations de transparence applicables à partir du 2 août 2026
En pratique :
- le code ne crée pas l’obligation
- il fournit une méthode pour s’y conformer
C’est là que le sujet devient important pour les entreprises.
L’Europe ne se contente pas d’imposer le signalement de certains contenus, elle organise une véritable chaîne de transparence.
En amont, les fournisseurs de systèmes d’IA générative devront :
- intégrer des mécanismes de marquage et de détection
- utiliser des tatouages numériques, des métadonnées et des signaux lisibles par machine
- concevoir des dispositifs capables de survivre à la circulation des contenus
En aval, les déployeurs devront se poser une question clé :
- lorsqu’ils publient une image, une vidéo, un son ou certains textes générés par IA, doivent-ils informer le public ?
La réponse est particulièrement sensible pour :
- les deepfakes
- les contenus textuels sur des sujets d’intérêt public
Le code est intéressant car il ne se limite pas à une conformité abstraite.
Il oblige les organisations à clarifier leurs usages et leurs responsabilités :
- qui génère le contenu
- qui le modifie
- qui le publie
- qui décide de l’étiquetage
- qui conserve la preuve
- qui assume la responsabilité éditoriale
Cette dernière question est l’une des plus délicates.
La frontière entre assistance et génération autonome est floue :
- un texte entièrement produit par IA puis relu n’est pas équivalent
- à un contenu humain simplement corrigé ou reformulé
Dans la pratique, ce sont ces nuances qui créeront les vrais sujets juridiques.
Le code ne changera pas tout immédiatement :
- il ne rendra pas les deepfakes automatiquement détectables
- il ne supprimera pas les risques de désinformation
- il ne définira pas toujours clairement la frontière entre assistance et génération
En revanche, il change quelque chose de plus profond :
La transparence devient une architecture de conformité.
Ce n’est plus seulement :
- une mention en bas d’une vidéo
- un pictogramme
- une phrase du type “contenu généré avec l’aide de l’IA”
C’est désormais :
- un processus structuré
- un choix de gouvernance
- un sujet contractuel avec les prestataires
- un enjeu de preuve en cas de contrôle
- un facteur de responsabilité si le public est induit en erreur
⚖️ Le vrai tournant est peut-être là : avec le RGPD, les entreprises ont appris.
- qu’il ne suffisait pas de respecter la règle
- qu’il fallait aussi pouvoir le démontrer
Avec l’AI Act, cette logique s’étend aux contenus synthétiques.
La confiance numérique reposera désormais sur la capacité à :
- identifier ce qui a été généré
- comprendre ce qui a été manipulé
- tracer ce qui a été relu et validé
- assumer ce qui est publié
Les directions juridiques devront construire une doctrine interne très concrète :
- quels contenus marquer
- quels contenus labelliser
- quelles exceptions documenter
- quels prestataires encadrer
- quelles preuves conserver
- quelle responsabilité éditoriale revendiquer
La transparence des contenus IA n’est plus un sujet de communication, elle devient un sujet de conformité.
Selon vous, les entreprises sont-elles prêtes à traiter la transparence des contenus générés par IA comme une véritable chaîne de responsabilité, ou vont-elles découvrir trop tard que les mentions vagues ne suffisent plus ?